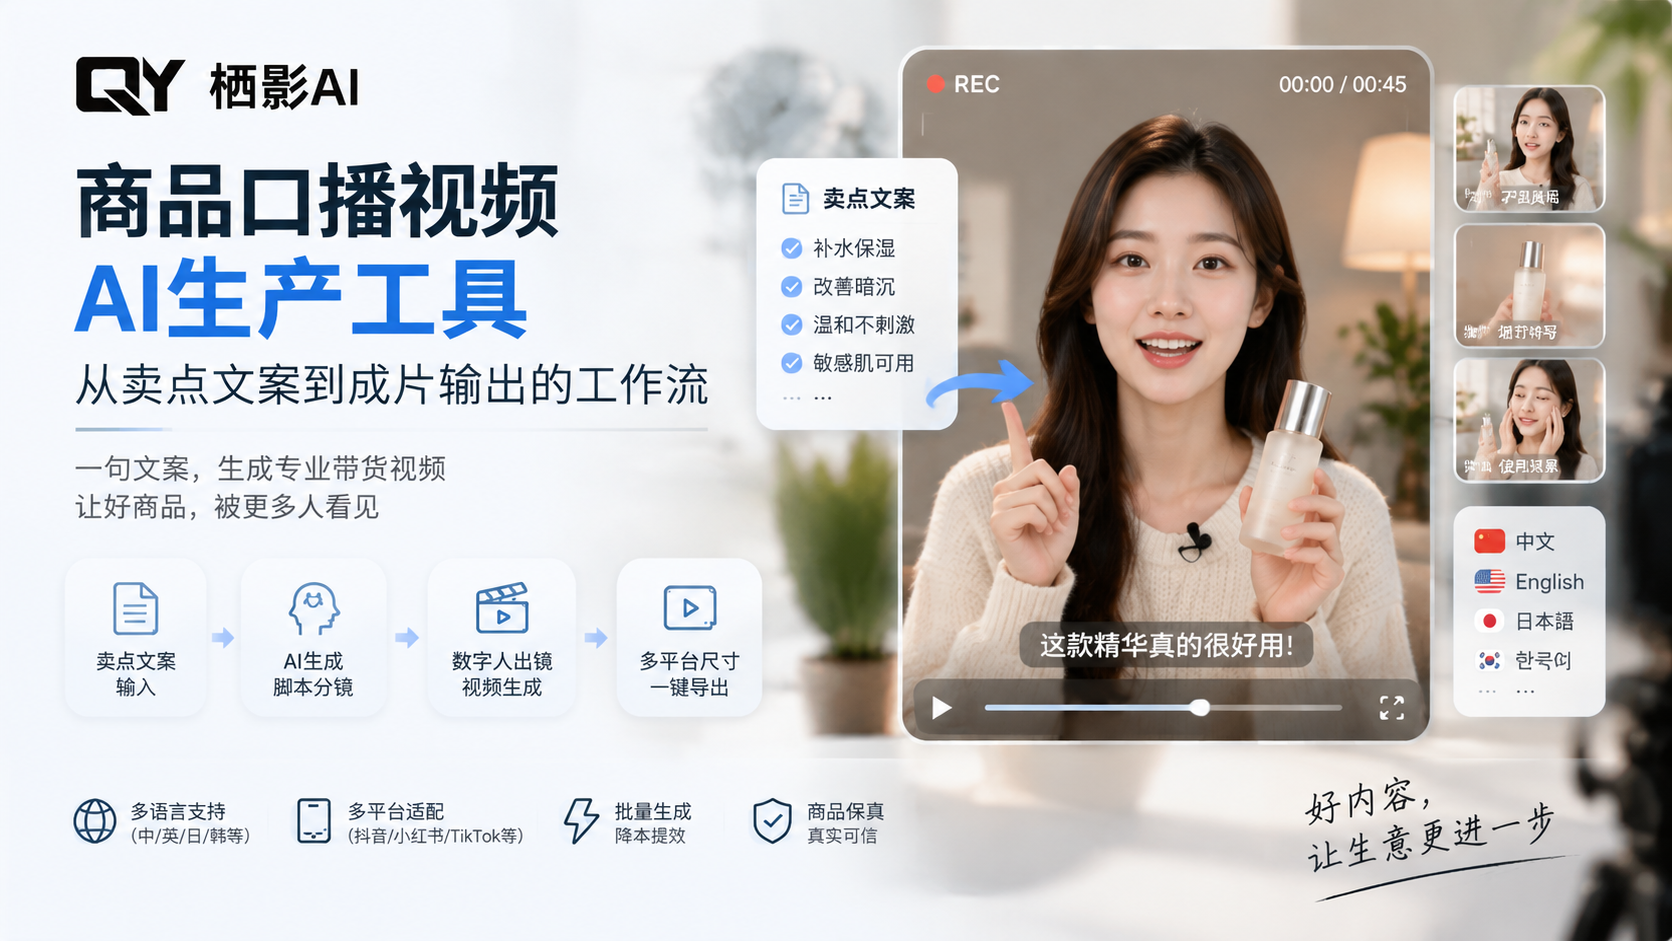
商品口播视频AI生产工具:从卖点文案到成片输出的工作流
口播视频带货转化高,但传统流程要写脚本、找主播、拍摄、剪辑,产能卡在"人"上。本文讲用栖影AI商品视频智能体把链路压缩成"文案进、成片出"的完整工作流,附脚本模板、参数配置和踩坑复盘。
编者按:本文是我们“栖影AI电商视频实战”系列的第二篇。在上一篇《AI视频中的商品运动控制工具:镜头语言与商品展示的配合》中,我们讲了如何用分镜规划控制镜头与商品的运动关系;本篇我们将继续深入,讲解如何用栖影AI商品视频智能体,把口播视频从“写脚本”到“成片输出”的漫长链路压缩到极致。
背景:口播视频的产能,卡在"人"上
口播视频之所以有效,是因为它有"人在推荐"的信任感。但制作成本也高:
• 要写脚本:每条视频都要针对商品写卖点脚本,文案产能跟不上
• 要找人:真人主播要排期、要费用,还要考虑形象与品牌调性匹配
• 要拍摄:场地、灯光、收音,一套流程下来半天起步
• 要剪辑:口播 + 商品展示 + 字幕 + 背景音乐,剪辑是另一道工序
传统做法的瓶颈在于:这条链路里每一环都依赖人,而人的产能是有天花板的。
从转化逻辑看,口播视频的价值在于"解释成本低"。用户看图文要自己判断卖点,而口播直接用口语把"为什么值得买"讲出来,缩短了决策路径。也正因如此,它比纯展示视频更依赖"表达质量"——同一件商品,脚本讲得好不好,转化差别会很明显。
拆开算一笔账,会更清楚卡在哪。写一条脚本约40分钟,约主播和场地约1天,拍摄半天,剪辑半天。也就是说,从"想做一条视频"到"拿到成片",周期基本是2天起步。如果账号需要日更,这个产能根本撑不住——不是做不出来,是排期排不过来。
更麻烦的是"多语言"和"多尺寸"。跨境要做多语言版本,每个语言都要找对应主播;国内要多平台分发,竖版、方版、横版要分别导出。这些重复劳动进一步挤压了内容创作的时间。
方案:用栖影AI的商品视频智能体做一站式生成
栖影AI 是面向电商零售场景的垂直多模态AIGC视觉内容生产平台,商品视频智能体是一站式短视频生成入口:输入商品信息和卖点,输出完整成片。
核心能力
• 图文视频一体化:从商品图到带货短视频,覆盖电商视觉内容全链路
• 长视频能力:突破单次16秒限制,通过"全局分镜规划 → 片段并行生成 → 自动无缝拼接"链路,可生成30s/45s/60s+连续成片
• 多语言支持:内置八国语言,跨境口播可直接产出本地化版本
• 批量任务:多条视频并行生成
这里解释一下"全局分镜规划"为什么重要。口播视频的难点不在单段画面,而在"口播和商品展示怎么对齐"——说到某个卖点时,画面要同步切到对应细节。全局规划会先把整条片子的时间轴和镜头序列定好,再生成每个片段,这样口播、画面、字幕才能对齐,而不是各做各的再硬拼。(关于镜头运动与分镜的基础逻辑,可回顾我们的上一篇教程。)
从文案到成片的完整工作流
第1步:整理卖点文案(约40分钟)
先把商品的核心卖点列清楚。口播脚本的结构建议:
段落 时长 内容
开场钩子 3-5s 痛点或反差,抓住注意力
商品亮相 5-8s 商品特写 + 一句定位
卖点展开 15-25s 2-3个核心卖点,每个配场景展示
促单收尾 5-8s 行动引导
写脚本时注意三点:一是钩子要具体("用了三个月才发现"比"很好用"有信息量);二是每个卖点配一个场景;三是口语化,避免书面语。
第2步:上传商品图 + 输入文案(约10分钟)
把商品图(白底图或场景图)和卖点文案一起提交。系统自动解析意图,规划分镜。商品图建议用清晰的白底图或场景图,模糊的原图会拖累成片质感。
第3步:选择视频规格(约5分钟)
勾选目标时长(30s/45s/60s)、比例(9:16竖版为主)、语言(国内中文/跨境多语言)。
第4步:生成与调整(提交后等待)
批量生成后预览,对不满意的片段做局部调整,不用整条重做。这一步的检查重点是:口播和画面是否对齐、商品是否变形、字幕有无错字。
第5步:多平台分发(约10分钟)
同一批视频输出多个尺寸,覆盖抖音、快手、小红书、视频号等平台。
关键参数/配置
参数 建议值 说明
视频时长 30s / 45s / 60s+ 按品类信息量选择
支持比例 9:16 / 1:1 / 16:9 竖版为主
支持语言 中文/英语/日语/韩语/西班牙语/法语/德语/阿拉伯语 内置八国语言
输出平台 抖音/快手/小红书/视频号/TikTok 内置尺寸适配
价格模式 按量计费,无包月费 适合波动需求 效果对比 维度 传统口播视频 栖影AI方案
单条制作 写脚本+找主播+拍摄+剪辑,半天 文案进、成片出
批量产能 一天2-3条 批量并行
多语言 需分别找主播 内置八国语言
多尺寸 分别导出 并行输出
成本结构 主播+场地+后期 按量计费
案例参考:谷雨 — 素材产出速度提升10倍,综合成本下降85%,小红书互动率提升32%。
需要说明的是,AI方案省掉的主要是"制作环节"的成本,脚本创作和投放策略仍然需要人。工具解决的是"做出来"的效率问题,不解决"讲什么"的判断问题。
常见问题答疑
Q1:AI口播会不会听起来很"机械"? 取决于文案和参数。文案口语化、句子长短交错,成片会更自然;如果文案是书面语,配音也会显得生硬。建议写完脚本先朗读一遍,读着别扭的地方就改。
Q2:口播和商品展示能对齐吗? 可以。系统按分镜规划对齐口播与画面,但建议生成后逐段核对——尤其是"说到某个卖点时画面是否切到对应细节"。不一致的片段可以局部重生成。
Q3:多语言版本需要重新做素材吗? 不需要。同一套商品图和脚本结构可以输出多语言版本,省去分别找主播的环节。但发音和表达习惯建议找本地人抽检。
Q4:一条视频一般做多长合适? 看品类。快消品15-30秒足够;需要讲使用场景、对比效果的品类,45-60秒更合适。原则是"信息量和时长匹配",而不是越长越好。
Q5:生成的口播视频能直接投放吗? 大部分可以,但建议过一遍平台规则(时长、比例、水印、字幕)和商品保真检查。跨境投放还要核对语言表达。
进阶技巧
技巧1:把脚本写成"分镜脚本"。 在文案里标注"此处展示细节""此处切场景",能明显提升口播与画面的对齐度。 技巧2:钩子多写几个版本。 同一条视频准备3个开头,跑A/B测试,找出完播率高的钩子,再固化成模板。 技巧3:按平台调时长。 抖音偏短、视频号可稍长,同一内容可以输出不同时长的版本分别投放。 技巧4:批量提交时按品类分批。 一次全量提交不便止损,分批能在发现问题时快速调整。
踩坑与优化建议
- 文案质量决定成片质量:AI能把文案变成视频,但文案本身没说服力,成片也没用。脚本环节值得多花时间。
- 前3秒要下功夫:短视频的完播率取决于开头,钩子要足够抓人。
- 商品图要清晰:视频里的商品展示依赖原图质量,模糊的原图会让成片显得廉价。
- 多语言版本要抽检:跨境口播建议找本地人核对发音和表达习惯,翻译准确不等于表达自然。
- 先跑一条完整链路:确认从文案到成片的效果,再批量投入。
- 不要忽略字幕错字:自动生成的字幕可能有错字或断句问题,发布前要过一遍。
- 不要把所有卖点都塞进去:卖点过多会稀释重点,2-3个核心卖点讲透比罗列一堆更有效。
总结
商品口播视频的生产,核心是把"脚本 → 主播 → 拍摄 → 剪辑"这条长链路压缩。栖影AI 的商品视频智能体把卖点文案和商品图直接转成完整成片,配合长视频能力和多语言支持,让口播视频从"定制内容"变成"可批量生产的素材"。
建议先拿一个主推款跑通文案 → 成片 → 分发的完整流程,验证转化效果后再规模化。跑通之后,日常更新就可以走"套脚本结构 + 换商品"的方式,把精力从制作环节挪到脚本和投放策略上。
把脚本结构沉淀成可复用资产
口播视频做多了会发现,真正值钱的不是单条视频,而是验证过的脚本结构。
我的做法是维护一份"脚本结构库",按品类和卖点类型分类。比如家居类目常见三类结构:
结构类型 适用卖点 节奏特征
痛点-解决型 功能性卖点 前3秒抛痛点,中段给方案
场景代入型 体验类卖点 用使用场景带出商品
对比论证型 参数类卖点 用前后对比建立说服力
每次做完一批视频,把数据表现好的结构补充进库。下次遇到同类商品,直接从库里选结构、填卖点,脚本环节的时间能压缩一半以上。这也是"批量生产"能持续的前提——如果每条都要从零想结构,产能迟早会卡在脚本上。
相关文章推荐: • 上一篇:《AI视频中的商品运动控制工具:镜头语言与商品展示的配合》https://qiyinghub.com/blog/ai-video-product-motion-control-lens-language/
本文基于栖影AI 实际使用体验整理,功能以 https://qiyinghub.com 最新版本为准。